【第2回】Google Colab の A100 で MiniMax H3+Pika H3 Flex——ComfyUI で、用意した声どおりにキャラを口パクさせる
Google AI Pro の Colab で A100 を借り、ComfyUI で MiniMax H3(参照から作る ref2va)と、6 段で作れる LoRA の Pika H3 Flex を回した。声を参照に入れたら言葉が崩れた。セリフの文字をプロンプトに書き、無音付きの声トラックを AddGuide で固定すると、用意した声どおりに口が動いた(リップシンク)。作り方、時間、ユニット、ハマりどころ。
← 前の記事: 【第1回】ComfyUI でAI動画をアップスケール——SeedVR2 と 4x-UltraSharp を比べて Shorts 用に高画質化AI 生成動画(MiniMax H3+Pika H3 Flex)。音は Irodori-TTS で作った元の声に差し替えてある。一部の地域では動画を再生できません。
ショートドラマの会話カットを作りたい。キャラが、こちらで用意したセリフの声どおりに口を動かすカットだ。
声は前から Irodori-TTS で作っている。マンガの PoC シリーズで、ノリ子とクロコのセリフを読ませている声だ。足りないのは、その声に合わせて口が動く絵のほうだった。
X で、MiniMax H3 に「Pika H3 Flex」という LoRA を足して、キャラ絵から会話の動画を作っている作例を見かけた。これを試すことにした。
上の動画が、たどり着いた結果だ。音は Irodori-TTS で作った元の声で、口はその声に合わせて動いている。最初の 1 秒は黙っていて、話し終わると口を閉じる。
MiniMax H3 と Pika H3 Flex
MiniMax H3 は、映像と音声を一緒に作る動画モデルだ。ComfyUI 本体(今回は v0.42.5)にノードが入っている。使ったのは 2 つ。
- MiniMaxH3ReferenceToVideo: 参照から動画を作る。キャラ絵を最大 9 枚、参照動画と参照音声を 3 本ずつまで入れられる。今回はノリ子とクロコの全身絵を 1 枚ずつ入れた
- MiniMaxH3AddGuide: 絵や音声を、動画の決まったコマに固定する
Pika H3 Flex は H3 用の LoRA だ。ComfyUI のモデル置き場(Hugging Face の Comfy-Org/MiniMax-H3)の loras/ に、参照から作る用と、画像から作る用が 1 本ずつ入っている(どちらも 2GB)。サンプラーは lcm、段ごとのノイズ量は ManualSigmas で 7 つの値を並べ、CFG なしで 6 段回す。LoRA なしでは 20 段で回した。
なぜ Colab か
参照から作る本体は、fp8 にしても 21GB ある。プロンプトを読むエンコーダー(Qwen3-VL 32B を 4bit にしたもの)が 16GB。動かしてみると、VRAM を最大 43GB 使った。手元の RTX 3090(24GB)では、そのままでは入らない見込みだ(試してはいない)。
2026 年 9 月 22 日、Google は Google AI のプランに Colab を含めると発表した(Colab is now part of your Google AI plan)。プランの契約者に、Colab の計算ユニットが毎月付く。数週間かけて、順に有効になっていく。
| プラン | Colab の計算ユニット(毎月) |
|---|---|
| Google AI Pro | 200 |
| Google AI Ultra | 2,000 |
(Google One のプランページの記載。2026 年 11 月 1 日に確認)
私が契約しているのは Google AI Pro だ。このユニットで A100 を借りられる。
Colab には公式のコマンドラインツール Colab CLI がある。ノートブックを開かずに、ターミナルから VM を借りる、ファイルを送る、Python を実行する、結果を取ってくる、止める、ができる。今回は Claude Code に、これを使って回してもらった。
借りた VM は A100 80GB、メモリ 167GB、ディスクの空き 194GB だった。
毎回入れ直す
Colab の VM は保存できない。止めたら消える。毎回 ComfyUI を入れて、モデルを取ってくることになる。
| 時間 | |
|---|---|
| VM の起動 | 約 5 秒 |
| ComfyUI の導入 | 28 秒 |
| モデル 5 本・42GB を Hugging Face から取る | 245 秒(並列で 171MB/s。1 本ずつだと 359 秒) |
| ComfyUI の起動 | 約 30 秒 |
合わせて 5 分ほど。生成なしのセットアップだけで 1.19 ユニットだった。
残しておく公式の方法は Google ドライブをつなぐことだが、使わなかった。VM からドライブ全体を読み書きできてしまうからだ。5 分で済むなら、毎回取ってくるほうが気が楽だ。
AI に GPU を借りさせるときに決めたこと
従量課金に転んで大きな請求が来る。止め忘れて回りっぱなしになる。秘密が漏れる。AI に回させるなら、なおさら怖い。決めたことは 4 つだ。
- サブスクの枠内だけで使う。ユニットを買い足さない
- 終わったら必ず止める。止め忘れたときに止める見張りも、別に置く
- ドライブはつながない
- API キーやトークンなどの秘密を VM に送らない。モデルは公開されているので、Hugging Face のトークンも要らない
試験 1: 声を参照に入れたら、言い直された
ノリ子が話すカットと、クロコが話すカットを 1 本ずつ作った。720×1280、124 コマ(約 5 秒)、Pika の 6 段。セリフの声は参照音声として入れて、プロンプトには「この声をそのまま使って」と書いた。セリフの文字は書かなかった。
AI 生成動画(MiniMax H3+Pika H3 Flex)。試験 1 のノリ子のカットで、音も H3 が作ったもの。
見た目はよかった。顔、髪、服、パーカーの文字は崩れていない。話すのはノリ子だけで、クロコは腕を組んで口を閉じたままだ。
だめだったのは声だ。元のセリフは「だから、人間の関門が要るのね。」。出てきた音を文字に起こすと、「なんが、ゼイコーテイシとせ、人間だお関門がいるののね。」だった。クロコのほうも「それが、本物の正常性バイアスです。」が「そう、それが本物の正常バイアスです」になった。
H3 は渡した声をそのまま使わず、真似て言い直していた。口は言い直した声に合っているので、あとから元の声に差し替えると、口がずれる。
試験 2: セリフを書いて、声を固定する
次は、ノリ子のカットだけを 3 通りで作った。今度はどれも、プロンプトにセリフの文字を書いた。
a と c の声は、最初の 1 秒を無音にし、そのあとにセリフを置き、残りも無音で埋めた 5 秒のトラックにした。これを AddGuide で 0 コマ目に固定する。
| 声の入れ方 | 段数 | 生成 | 書き起こし | 話す位置 | |
|---|---|---|---|---|---|
| a | AddGuide で固定 | Pika 6 段 | 142 秒 | だから人間の関門がいるのね | 渡したトラックと同じ(1.0〜3.75 秒) |
| b | 参照+セリフの文字 | Pika 6 段 | 130 秒 | だから人間の関門がいるのね | 0.17 秒目から |
| c | AddGuide で固定 | LoRA なし 20 段 | 381 秒 | だから人間の関門がいるのね | a と同じ |
書き起こしは faster-whisper、話す位置は音の大きさの変化で見た。
冒頭の動画が a だ。音を、渡した声トラックに差し替えてある。4 コマ/秒で並べると、こうなる。
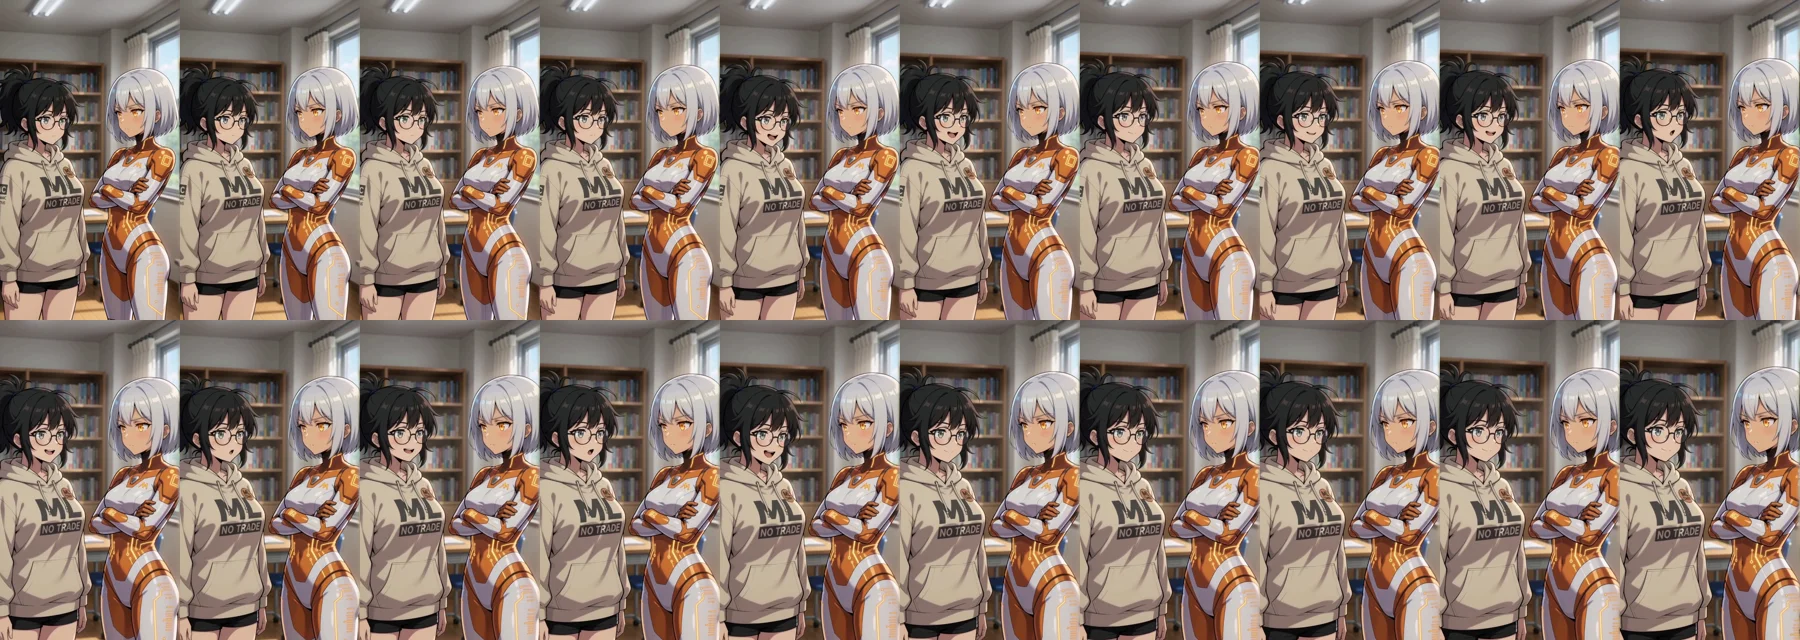
上の段の左 4 コマ(最初の 1 秒)は口を閉じている。5 コマ目から話し始め、話し終わると閉じる。クロコはずっと黙っている。
分かったこと:
- 言葉が崩れた主な原因は、プロンプトにセリフの文字が無かったことだった。 文字を書けば、参照に入れる b でも、元の声とほぼ同じ音が出た
- ただし b は 0.17 秒目から話し始める。話し始める位置は決められない
- AddGuide で固定すると、話す位置が渡したトラックどおりになる。出てくる音はモデルを通った音で、元の波形とは一致しない。それでも位置が同じなので、元の声に差し替えても口が合う
- 6 段と 20 段で、見た目にも口の合い方にも大きな差は見えなかった。時間は 20 段が約 2.7 倍。この試験の範囲では 6 段で足りそうだ
作り方
- セリフの声を作る(Irodori-TTS などで、1 セリフ 1 ファイル)
- 前に 0.5〜1 秒の無音を置き、後ろも無音で埋めて、動画と同じ長さのトラックにする(124 コマなら約 5.17 秒)
- プロンプトにセリフの文字をそのまま書く。黙っている間と話し終わったあとは口を閉じる、とも書く
- 1 カットで話すのは 1 人にする。黙る方には「does not speak」と書く。会話は切り返しで作る
- トラックを AddGuide で 0 コマ目に固定し、Pika の 6 段で作る
- 出来た動画の音を、手元の声トラックに差し替える(ffmpeg で音だけ入れ替える)
前に無音を置くのは、0 コマ目からしゃべり出す素材は編集で使いにくいからだ。動画の最初の数コマは落ち着かないことも多い。
プロンプトは、ComfyUI の公式テンプレートの形(subject_definitions: → summary:)に合わせた。試験 2 の a はこう書いた。
subject_definitions:
<Subject 1> is the young woman in <Picture 1>: messy black hair in a loose ponytail, round glasses, grey eyes, a beige oversized hoodie printed "ML NO TRADE", black shorts.
<Subject 2> is the young woman in <Picture 2>: silver-white bob haircut, amber eyes, a sleek white-and-orange futuristic bodysuit with glowing circuit lines.

summary:
Clean Japanese anime style with bold outlines, soft daylight, a simple bright study room with a bookshelf. Vertical medium shot from the waist up, <Subject 1> on the left and <Subject 2> on the right, both facing each other at a slight angle toward the camera; the camera slowly pushes in.
For the first second <Subject 1> looks at <Subject 2> in silence with her mouth closed. Then <Subject 1> says in Japanese: 「だから、人間の関門が要るのね。」 Her lips move in sync with her voice only while she speaks, and she gives a small thoughtful nod; after the line her mouth closes again. <Subject 2> listens silently with her arms crossed and does not speak; her mouth stays closed the whole time.
Audio: the soundtrack is exactly the given voice track: one second of silence, <Subject 1>'s line, then silence. No other voices, no music.英語で書き、セリフだけ日本語のまま入れている。<Picture 1> <Picture 2> は、キャラ絵をノードにつないだ順の番号だ。
時間とユニット
| 1 本の生成(720×1280・124 コマ・6 段) | 130〜142 秒 |
| 同じ条件で LoRA なし 20 段 | 381 秒 |
| VRAM の最大 | 約 43GB |
| ユニット: セットアップだけ | 1.19 |
| ユニット: セットアップ+2 本(試験 1) | 1.56 |
| ユニット: セットアップ+3 本(試験 2) | 約 2.2 |
ユニットの差し引きは遅れて出る。セットアップだけの回は、止めた直後に見ると 0.45 で、しばらくして 1.19 になった。
ハマりどころ
最初の命令で接続が切れ、16 分待たされた
試験 2 の 1 回目は、VM に最初の命令を送ったところで、Colab CLI と VM の接続が切れた(RuntimeError: Connection was lost.)。そのまま止まり、制限時間の 16 分まで待たされて、約 1.9 ユニットをむだにした。
いまは、最初に 1 分だけの接続確認を流し、切れたときだけ 1 回やり直すようにしている。やり直した 2 回目は普通に通った。
Hugging Face のトークンを探して止まる
VM の中で Hugging Face からモデルを取ると、Colab に登録したシークレット(HF_TOKEN)を探しに行く。ノートブックの画面の外から動かしていると、十数秒待ってタイムアウトする。モデルは公開されているので、hf_hub_download(..., token=False) で取れば消える。
ComfyUI に流すと 400
v0.42.5 では、動画を組み立てるノードと保存するノードに、必須の入力が増えていた。API から流すとき、ComfyUI の /object_info から既定値を読んで埋めた。
まだ分かっていないこと
- 2 人が同じカットで交互に話す(1 本の中で話者が替わる)のは試していない。いまは 1 カット 1 話者の切り返しで作る
- 5 秒より長いカット、720×1280 より大きい解像度での時間と VRAM
- 手元の 3090 で、参照から作る本体が動くか
試したのは、1 組のキャラで 5 本だけだ。セリフの文字と AddGuide の組み合わせは、ほかのキャラや長いセリフでも確かめていく。
次は、ショートドラマの会話を切り返しでつないでみる。出来たカットは 720×1280 なので、Shorts に出すときは第1回の拡大をかける。